

别再写 HTML 代码了。让我们把布局变成真正的 HTML
在我们开始之前
词汇表
简介
问题
我的解决方案
结论
下一步是什么?
您是否想过,手写 HTML 代码既昂贵又冗长,而且过时了?
每当我创建另一个 GUI 组件或系统元素时,我都会想到这一点。本文旨在概述该行业的现状及其问题,并分享我的研究成果。
在我们开始之前
想现在就试试吗?这是概念验证。
它展示了这个概念,虽然缺少具体实现,但我认为它已经被证实了。详情如下。
这是我的第一篇英文文章,请多包涵。欢迎提出任何修改建议。
词汇表
我使用“HTML 代码”,我的意思是:
- 作为 HTML 开发过程。
- 作为HTML开发后得到的产物——HTML、CSS、JS等。
简介
大约8年前,我曾提出手动HTML编码已经过时,自动化将取而代之。从那时起,我就一直在努力寻找解决这个问题的方法。我们已经有了Workflow、Bootstrap Studio等工具,
inVision,
框架器、Supernova、React Studio 以及许多其他直接或间接的解决方案。
我们还通过 pix2code 或 sketch2code 使用神经网络对此主题进行了出色的研究。
不幸的是,我找不到可以完全集成到我的开发过程中的工具。
那么我想要什么呢?我希望从布局设计器中获取布局,将其分解成组件,修改HTML代码,在必要时添加逻辑,获取组件库,然后将其全部返回给设计器以供将来交互。我知道这甚至超越了业界最先进的能力,但这是我的梦想……
孔子说,万里长征始于足下,所以我决定好好想想从哪里开始。这就是这篇文章的主题。
问题
首先我们要确定HTML代码和界面的区别:
HTML代码——是一种半成品,粗略地说,是将图形格式转换为HTML,CSS和其他文件的结果,旨在进一步转换为图形界面。
界面——系统的一个产品就绪工件,可供用户交互。
在2020年,手动HTML编码仍然是创建Web界面的主要方式,这本身就很有趣。这与并行堆栈(例如原生和桌面应用程序)的趋势背道而驰,在这些应用程序中,可视化界面设计工具是其创建的标准。
我们可能会争论很长时间为什么会这样,但我认为,主要结论是:
- 对最终代码的要求很高,并且
- 需要低级控制
我建议将“HTML 编码人员大厅”留在括号外面:)。
HTML 编码很复杂,需要使用特殊的技术和工具来管理、最大限度地减少错误并支持最新。
动画是另一个大问题。制作复杂的动画对许多公司来说是一项不可能完成的任务,因为它非常耗费人力。
HTML 编码成本高昂,平均而言,SPA 系统的成本占整个系统的 25%,而登陆页面的成本则高达 75%。
目前还没有普遍接受的 HTML 编码理论。W3C
标准非常广泛,每个开发人员/团队都遵循自己的规则和标准。
我的解决方案
首先,我们必须形式化HTML 编码过程,定义实体、算法和规则。当然,这个主题本身相当广泛,其全面揭示并非本文的目标。基于此,我们仅考虑当前感兴趣的部分。
模板
让我们尝试定义模板创建的过程。
步骤 1
直观地划分为高级块树。
找到布局的行和列。
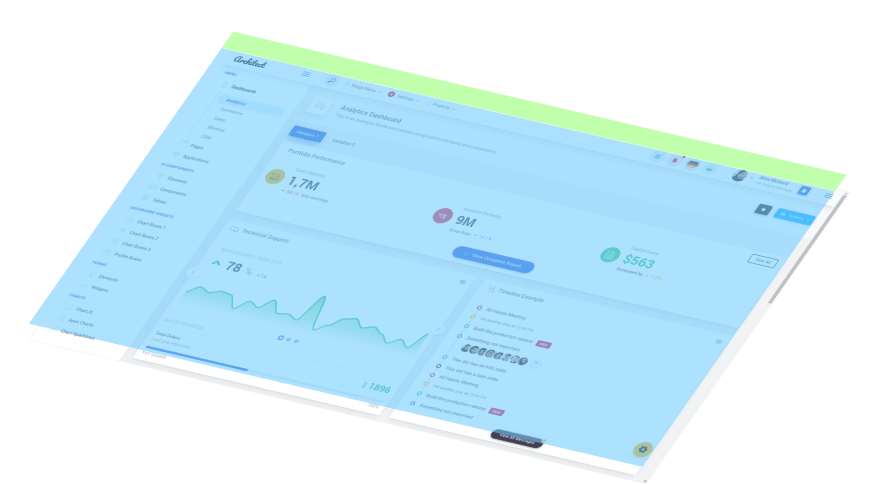
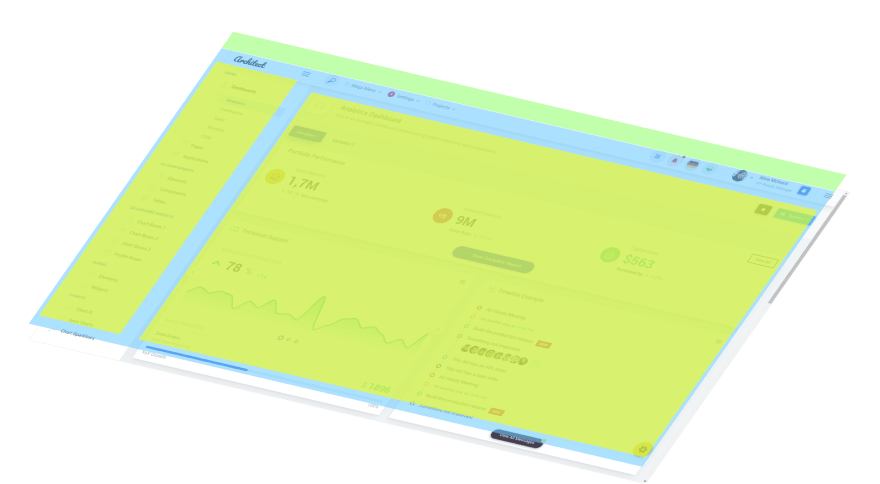
第 2 步
语义分析,我们定义主要的块:
- 标题
- 身体
- 侧边栏
- 页脚
- ETC…
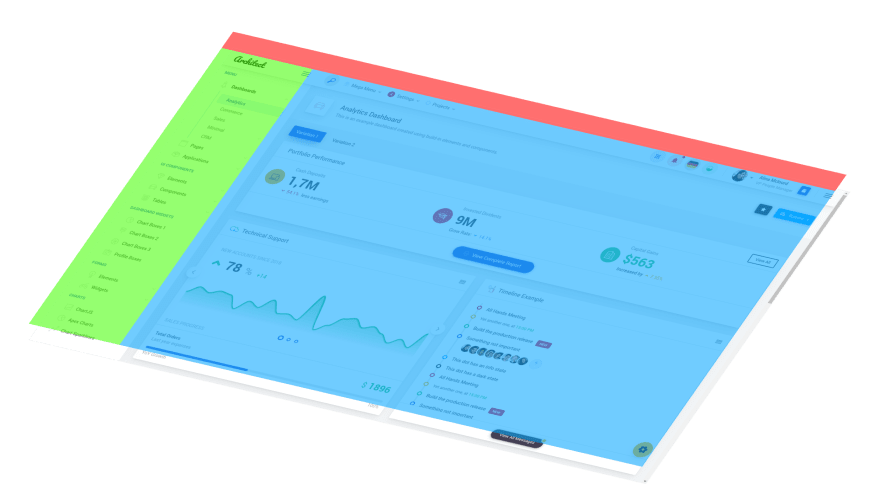
这里我们立即会遇到一个有趣的现象:布局并不总是足以构建完整的结构,因此界面设计师应该明确各个块的行为。这暗示着语义分析也并不总是足够的。
现在,这对我们来说已经足够了。在这里,我们可以将任务分为两大类:
- 技术和
- 语义的。
让我们先把语义组放在一边,留待以后研究,然后集中精力研究技术组。
尽管用神经网络编写图片的HTML代码
是一项非常有趣的任务,但在我看来,它是多余的。 很难想象在正常的工作流程中,界面设计师会以位图格式发送布局。
我们通常使用 Figma、Sketch 或 Adobe Photoshop 等工具创建的格式,这些工具已经包含有关布局的几乎详尽的信息,最重要的是:
- 元素位置;
- 元素类型;
- 元素样式;
根据这些信息获取 HTML 文档已经是一个已解决的问题,因为 Figma 的工程师已经分享了他们的转换实现和研究成果,而 Anima 等服务直接建立在布局和界面的同步之上。
但为什么这样的决定并没有产生炸弹般的效果,两年过去了,仍然没有什么比老式的手工编写的 HTML 代码更好呢?
我在这里重申一下我的观点,原因有两个:
- 高质量要求
- 需要控制
控制无疑是必要的,但如果不满足第一个要求,控制就没有任何意义。立即实现和管理高质量的HTML 代码比尝试修复质量低劣的 HTML 代码要容易得多。
因此,第一个要求至关重要。但是,什么才能保证代码质量呢?
如果我们移除 LTR、可访问性等官方质量指标,那么对于开发人员来说,我们仍然会保留重要的质量指标:
- 正确的树;
- 语义学;
- 非冗余;
- 可读性和可食用性;
- 仅在需要时才使用从流中取出的块。
因此,自动化的主要任务是遵守这些标准。
让我们尝试通过构建区块树来证明这一点。同样,为了做到这一点,我们需要将这个过程形式化,并引入必要的概念。留出一些极端情况以供将来研究。
行和列
行
如果一个元素的位置落入另一个元素的高度段,那么它们就形成一行。

列
类似地,如果一个元素的位置落入另一个元素的宽度段内,那么它们就形成一列。
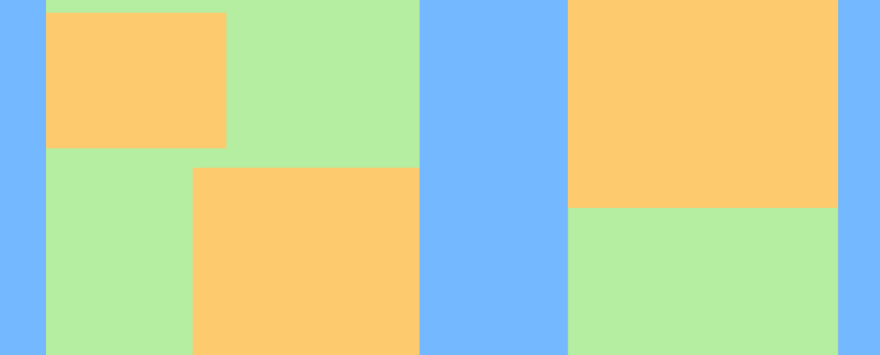
元素关系
相对布局
元素根据流程相对定位。
如有必要,树将完成。

重叠布局
重叠元素脱离流,绝对定位,不影响其他元素的定位。

构建块树的过程
步骤 1
定义所有行。
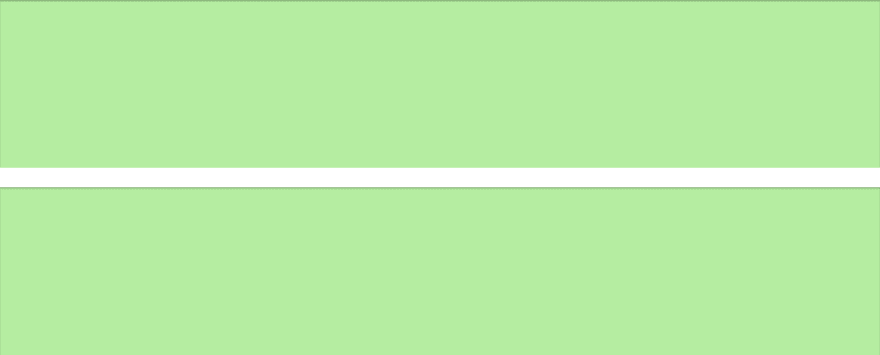
第 2 步
找到每行的边距。

步骤3
选择一行进行工作并确定布局类型:
- 单列;
- 多列;
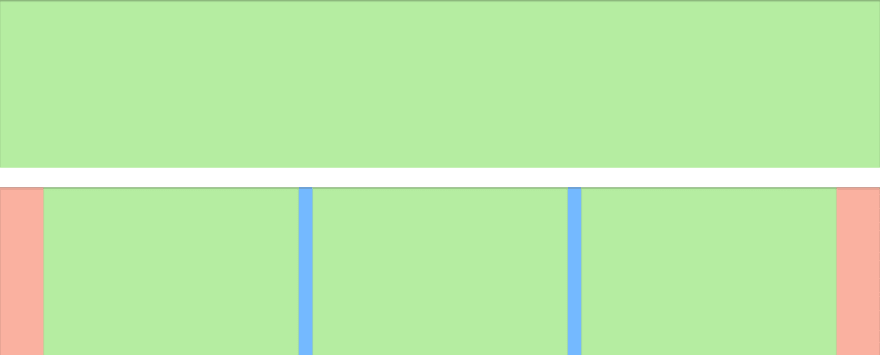
步骤4
对于多列,确定列的类型:
- 漂浮的;
- 网格;
根据类型,找到列之间的缩进。

步骤5
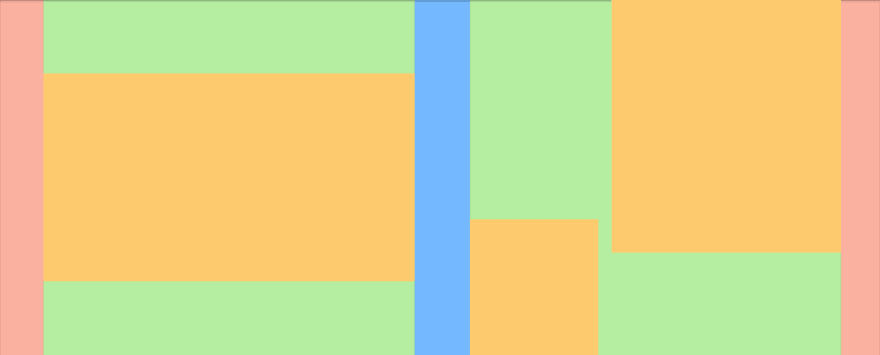
根据列中的元素数量确定列的类型:
- 单身的;
- 多种的。
如果类型是单一,则将元素相对于列定位,然后转到下一个。
步骤6
对于列类型“多”,我们查找所有行。
行类型与列类型类似:
- 漂浮的;
- 网格;
找到边距。
只要至少有一个原始块,我们就重复整个算法。

现在我们将得到的语句实现到代码中。
简化:
- 快速实施仅覆盖约 20% 的案例;
- 预计会出现定位错误;
- 源块的单级结构;
- 样式写入style属性;
您可以在此处查看并试用该概念的证明。
结论
无需依赖弱控制的机器学习算法,即可实现高质量HTML 代码的自动化。这将显著降低产品开发成本并提高产品质量。更重要的是,这将简化开发人员的工作,使其更加直观、愉悦。
但还需要进一步研究,而且问题本身需要社区更加密切的关注,以便在此基础上实现一个功能齐全的模型和工具。
下一步是什么?
我认为下一个重要步骤是确认可控性的概念。这里的关键在于将代码转换为布局。当代码更改时,布局也会更新——在设计工具和HTML 代码之间建立双向绑定。
很高兴看到任何建设性的批评和讨论。祝平安!
文章来源:https://dev.to/pashaigood/no-more-html-coding-please-let-s-make-layout-to-html-real-58o4